上下文工程

- 只能间接影响缓存。通过修改文本消息调整上下文,无法直接控制保留的 KV。
- 引入重复计算。改写前缀会使后续 KV 失效,需要重新预填充。
- 丢失历史信息。重新计算 B 时如果不再包含 A,B 的新缓存就会丢失来自 A 的信息。
面向智能体的推理服务,支持缓存工程。
研究洞察
直接管理缓存,复用已计算的历史状态。
AKV 的缓存管家会追加缓存,移除选定缓存并保留其他位置,也会单独调整保留缓存的位置。这是一段示意动画。
2 块活跃缓存
上下文工程
智能体不断积累历史,但并非所有历史都需要保留。
修改文本前缀会使后续 KV 失效,剩余上下文必须重新进行预填充。
缓存工程
它保存了此前已经计算好的状态。
直接决定保留或移除哪些 KV 状态。
核心思路
历史越长,KV 存储和注意力计算的开销越大。上下文工程通过修改文本精简历史,缓存工程则直接管理 KV 状态。

缓存内部的小色块表示从先前消息中保留的信息。
我们定义了三种缓存操作:Append、Drop 和 Repos。智能体可以组合这些操作,在执行任务时管理当前使用的缓存。
Append(追加)。基于活跃缓存计算新 token,追加其 KV 状态,并推进逻辑序列和位置编码。
AKV 推理服务系统
缓存经过 Append、Drop 和 Repos 操作后,即使 token 前缀和保留位置相同,其内容也可能不同。AKV 同时记录 token 历史和缓存操作历史,确保缓存能够被正确复用和恢复。
为什么需要记录缓存历史
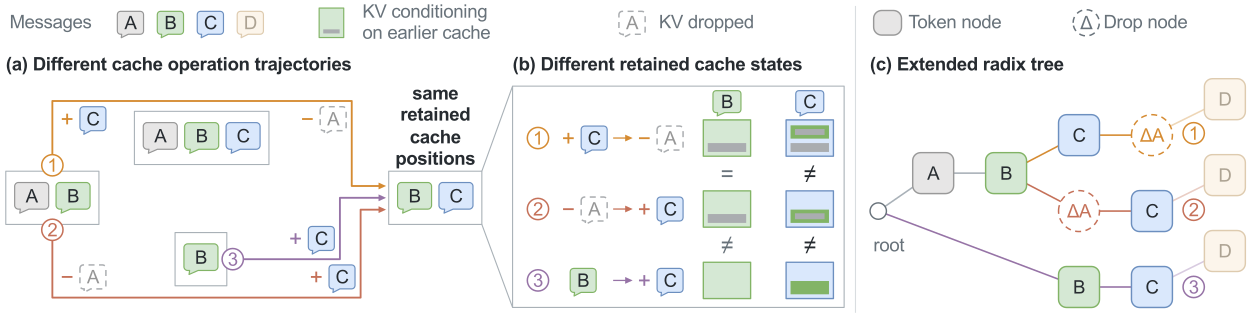
01 / 复用
扩展基数树同时匹配 token 和缓存操作历史,让兼容状态继续在不同请求之间共享。
02 / 回收
从一个请求中移除 KV,不会立即释放共享存储。只有当前计算和状态恢复都不再需要它时,AKV 才会回收,同时保持其后代缓存节点可访问。
03 / 恢复
通过分段批量注意力,AKV 在一次预填充中还原各段历史的注意力范围和位置编码,重建缺失状态。
每个请求携带完整的消息和操作历史。服务端直接复用已有的兼容 KV,并恢复缺失状态。
{
  "model": "gpt-oss-120b",
  "messages": [
    {"role":"user", "content":"Search ICLR"},
    {"role":"assistant", "content":"Searching"},
    {"role":"tool", "content":"ICLR is..."}
  ],
  "cache": {
    "drop": {"1": [0], "2": [1]},
    "reposition": [2]
  }
}
每个请求都包含此前的消息和操作。示例中简写了消息字段。
服务端 · 保留计算结果
发送消息 0,不执行其他缓存操作。
发送消息 0–1。复用消息 0 的 KV 计算消息 1,再移除消息 0 的 KV。
发送消息 0–2,并带上此前的移除操作。复用消息 1 的 KV 计算消息 2,移除消息 1 的 KV,然后重定位保留的键。
仅展示预填充状态,省略解码;token 位置仅作示意。Drop 改变活跃 KV,不改变消息历史。
基准测试
在 3 个模型、4 项智能体基准上,AKV 相较 Standard 的平均成功率提高 1.7 个百分点,推理成本降低 27.7%。
达到较高阈值后进行摘要。
达到较低的 48K token 阈值后进行摘要。
移除较早的工具响应 KV,仅保留最近 12 轮。
3 个模型 · 4 项智能体基准测试
成本根据活跃输入和生成输出的长度,按对应 API 价格估算。GPT-OSS-120B 使用 Groq 价格,MiniMax-M2.7 使用 MiniMax 价格,MiroThinker-1.7-Mini 使用 Qwen3-30B-A3B 官方价格。经过重定位的 token 按缓存命中计费。
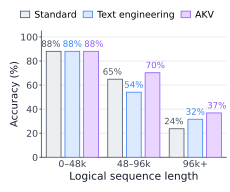
在 GPT-OSS-120B 的 BrowseComp-Plus 测试中,逻辑序列长度低于 48K token 时,三种方法的准确率接近。轨迹变长后,基线方法的准确率比 AKV 下降更快。我们认为,这一差距源于摘要过程中的信息损失。
缓存工程保留已有的 KV 状态,其中仍可携带来自已移除历史的信息。
更少的缓存读取。移除较早的工具响应 KV,减少后续请求访问的历史,使缓存读取成本相较于 Standard 降低约 19%。
更少的重复预填充。复用保留的 KV,避免摘要改写前缀后重新计算,使输入成本相较于 Text Engineering 降低约 57%。
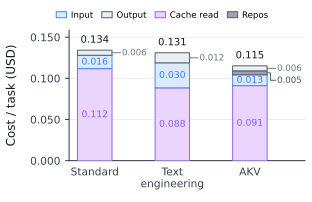
Standard。GPT-OSS-120B(128K 上下文窗口)和 MiniMax-M2.7(200K 上下文窗口)在 96K token 时触发摘要;MiroThinker-1.7-Mini(256K 上下文窗口)在 192K token 时触发摘要。
Text Engineering。三个模型均采用较低的 48K token 摘要阈值。
两种基线均采用基于 Pi 的策略,沿用其提示词、对话序列化方式、截断位置选择,以及默认的保留和摘要输出预算。摘要依据精确的提示词 token 数触发。
摘要使用智能体自身的模型和推理设置,替换较早的对话,并保留系统与开发者指令及选定的近期消息。空摘要不被接受;失败按基准测试的错误协议处理,不重试。
在 GPU 预算有限时,这些改进也带来了更好的任务表现。在独立的 100 道 SWE-bench Verified 任务实验中,AKV 用更少的 GPU 小时达到更高的最终成功率。
在下方独立的并发测试中,Standard 在 C=12 时达到最高输入和输出吞吐量。C=14 和 C=16 时,KV cache 压力导致更多重复预填充,服务性能下降。因此 Standard 采用 C=12,避开这些性能退化的设置;Text Engineering 和 AKV 使用 C=14。这项任务成功率对比采用了不同的并发数。

推理服务效率
在长上下文智能体任务中,AKV 在所有测试并发数下均优于两种基线:输入和输出吞吐量更高,P95 首 token 延迟和请求延迟更低。
GPT-OSS-120B · 80 道长上下文 SWE-bench 任务 · 8 张 A800 GPU
token/秒 · 越高越好
token/秒 · 越高越好
秒 · 越低越好
秒 · 越低越好
硬件。8 张 A800-80GB GPU 以 BF16 运行 GPT-OSS-120B,其中 4 张用于预填充、4 张用于解码,张量并行度均为 4。两种基线都使用 SGLang;AKV 在其基础上增加缓存操作支持。
工作负载。各方法使用相同的 80 道任务及顺序,任务按峰值上下文长度选取。每种方法回放各自策略产生的轨迹,因此交互轮次和输出长度可能不同。工具响应通过回放提供,温度设为 0,并指定输出长度。
测量窗口。AKV 在 C=14 和 C=16 时测量到前 30 道任务完成为止,统计窗口内的全部请求。高并发 Standard 使用一小时窗口。任务完成后补充新任务以维持并发数,截止时可能仍有未完成请求。
指标。TTFT 为首 token 延迟,TPOT 为每个输出 token 的平均耗时。仅 TPOT 降低,并不意味着整体吞吐量提高。
独立的 80 道任务回放实验中,在并发数 16 下相较于 Standard 的提升。
在相同批大小下,GPT-OSS-120B 每步解码的全注意力耗时从 7.082 ms 降至 2.849 ms。这几乎占了总耗时从 26.186 ms 降至 21.990 ms 的全部降幅。
执行 Drop 后,解码只关注保留的活跃上下文。每一步从显存加载的 KV 数据更少,对历史 token 的注意力计算也随之减少。
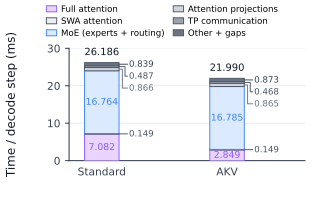
在测试的 C=14 和 C=16 设置下,KV cache 压力使 Standard 花费更多时间重新预填充,同时进行解码的请求反而减少。因此,即使请求延迟上升、吞吐量下降,TPOT 仍可能降低。应结合上方四项指标判断整体服务性能。
递归自我改进
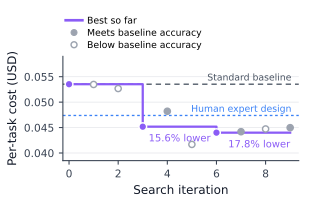
滚动移除只是起点。借助 AKV 的缓存接口,智能体还可以自行探索新策略,通过评估不断改进。
在 BrowseComp-Plus 上,MiniMax-M2.7 经过 6 轮迭代,在达到 Standard 准确率的同时,将成本相较 Standard 降低 17.8%。
研究团队
引用
如果 AKV 对研究有所帮助,欢迎引用我们的论文。
@article{fu2026akv,
    title={Cache Engineering for Agents},
    author={Tianyu Fu and Ruoxi Wang and Zihan Min and Zhongqi Ren and Zhihao Li and Tengxuan Liu and Shengxu Mu and Hanling Zhang and Yu Wang},
    journal={arXiv preprint arXiv:2610.28577},
    year={2026},
}