Cache-to-Cache
投影并融合 KV cache,让模型直接交流语义,减少信息损失与通信延迟。
概览
模型交流,不止于文本
模型各有所长,协作可以取长补短。但仅靠文本交流,既难以完整传递模型的理解,也会增加生成开销。
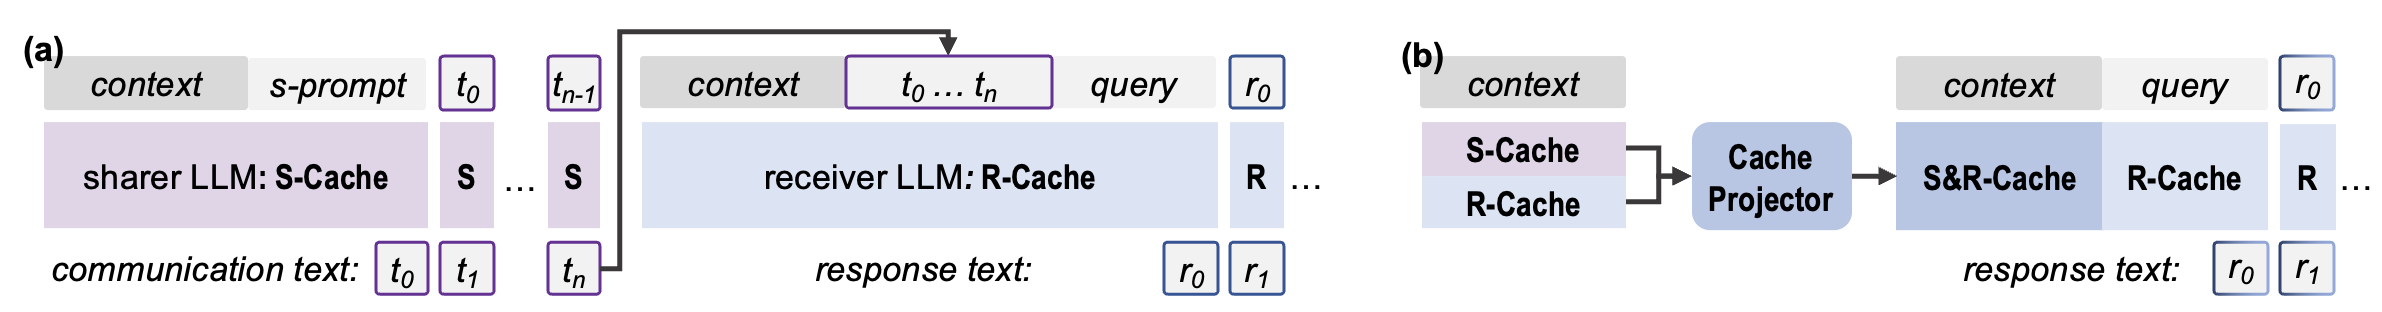
研究动机
文本通信有哪些局限?
模型之间的文本通信存在三方面局限。
信息瓶颈
高维语义表示被压缩为线性的文本序列,信息难以完整保留。
语义歧义
自然语言可能有多种解读,接收模型未必能准确理解发送模型的意思。
通信延迟
每轮交流都要逐个生成 token,通信过程缓慢。
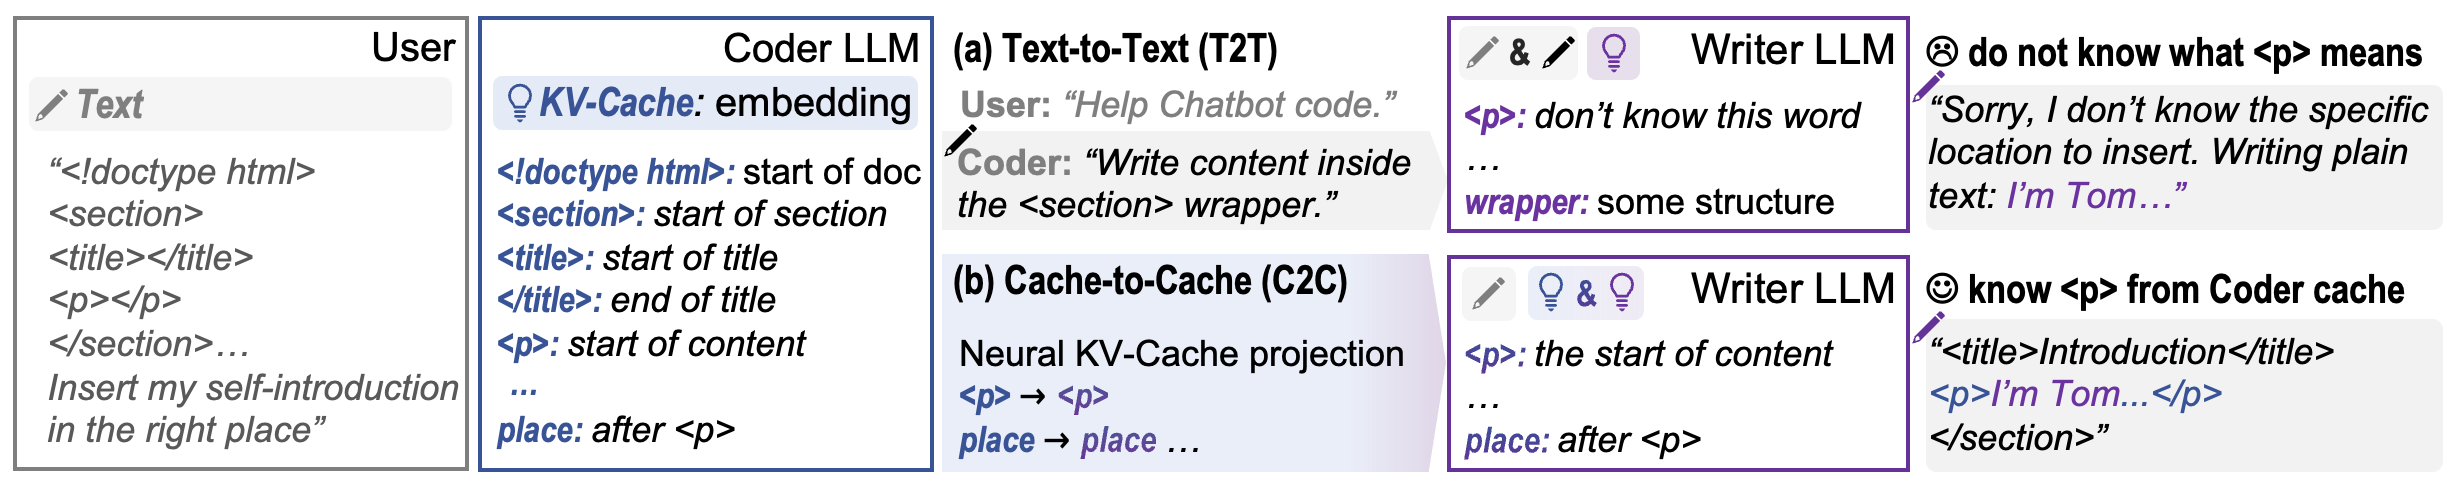
示例:文本描述中的歧义会损失结构信息;C2C 直接传递模型内部的语义表示,减少这类信息损失。
关键发现
KV Cache 承载着语义信息。
三组理想化实验表明,缓存中的语义可以增强、转换,并在模型间互补。
实验一:增强缓存语义
问题:不增加缓存长度,仅丰富 KV cache 的语义,能否提升回答质量?
少样本提示带来的提升,究竟来自额外的 token,还是问题在 KV cache 中更丰富的表示?我们先对示例与问题 E⊕X 进行预填充,再丢弃示例 E 对应的缓存,只保留问题 X 对应的部分。
- 直接回答:准确率 58.42%,缓存长度为 |X|
- 少样本提示:准确率 63.39%,缓存长度为 |E| + |X|
- 增强缓存:准确率 62.34%,缓存长度仍为 |X|
发现:丢弃示例缓存后,大部分收益仍然保留。问题缓存已吸收了示例中的信息,不必在后续生成中一直关注这些示例。
实验二:跨模型转换缓存
问题:一个模型的 KV cache 能否被另一个模型使用?
我们训练了一个三层 MLP,将 Qwen3-4B 的 KV cache 映射到 Qwen3-0.6B 的表示空间。t-SNE 可视化显示,转换后的缓存进入了目标模型的表示空间。
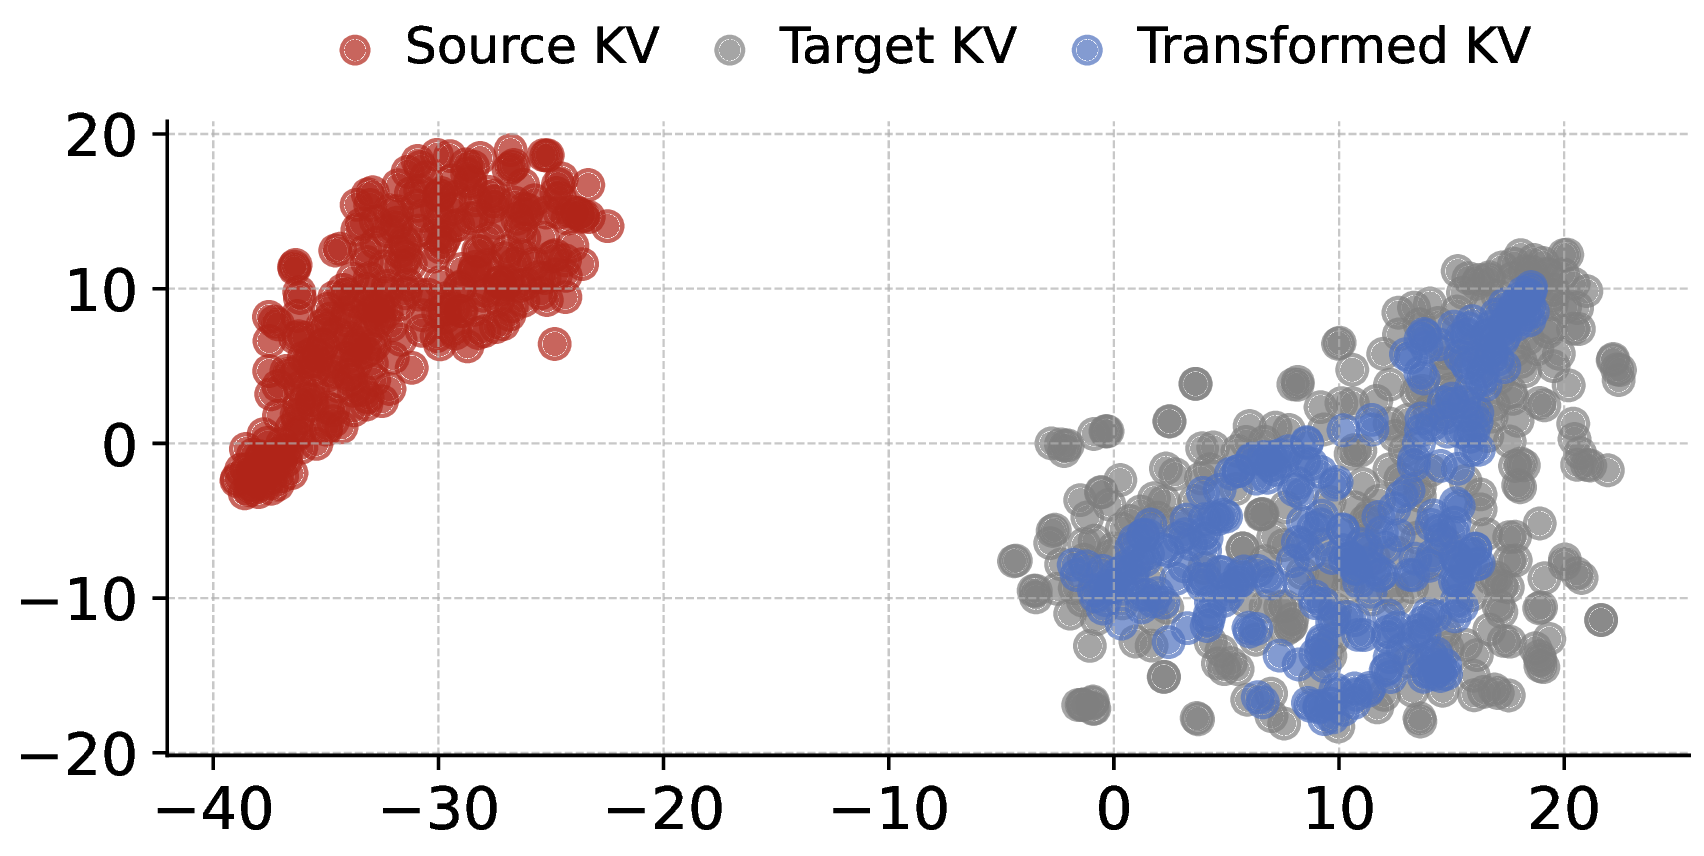
发现:转换后的缓存只覆盖目标表示空间的一部分,反映出模型对语义的不同理解。融合这些表示,有望发挥模型之间的互补优势。
方法设计
Cache-to-Cache 融合模块
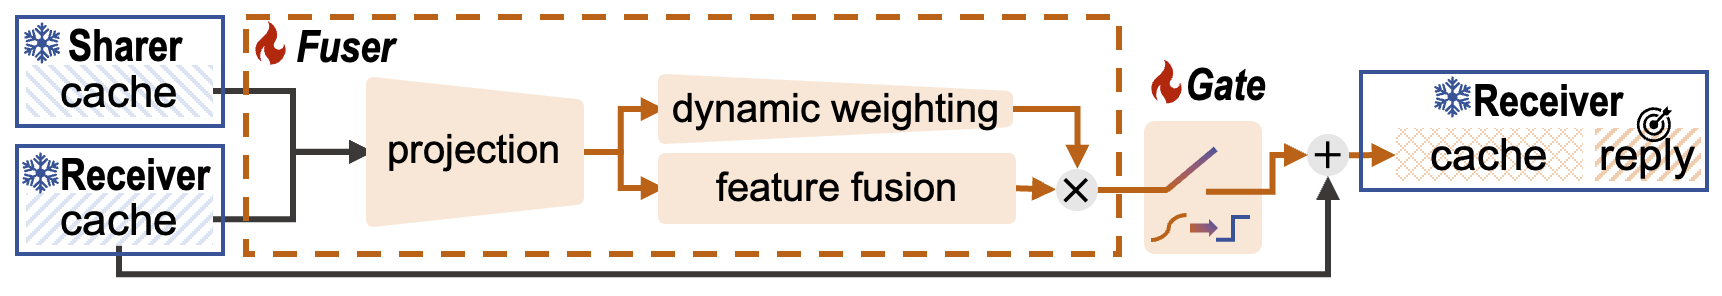
C2C Fuser:先投影并融合两个模型的 KV cache,再由可学习门控控制,以残差形式加入接收模型的原有缓存。
投影模块
拼接两个模型的 KV cache,通过投影层和特征融合层完成表示转换与融合。
动态加权
根据输入动态调整注意力头的权重,自适应地控制模型间的信息传递。
可学习门控
逐层门控决定是否融合;动态权重随输入变化,调节注入信息的强度。
训练:冻结两个模型,仅通过下一 token 预测损失训练 C2C 模块。
研究总结
主要贡献
直接交流语义
通过学习 KV cache 投影与残差融合,实现模型间的直接语义通信。
更准确,也更高效
以 Qwen2.5-0.5B 为共享模型,C2C 在四项基准上使 Qwen3-0.6B 的平均准确率提高 11.0 个百分点,相较 T2T实现 3.46× 延迟加速。
适配多种模型
训练融合模块并完成 token 与层的对齐后,可组合不同家族、规模和专长的模型。
引用
引用本研究
如果 C2C 对研究有所帮助,欢迎引用我们的论文。
@article{fu2025c2c,
  title={Cache-to-Cache: Direct Semantic Communication Between Large Language Models},
  author={Fu, Tianyu and Min, Zihan and Zhang, Hanling and Yan, Jichao and Dai, Guohao and Ouyang, Wanli and Wang, Yu},
  journal={arXiv preprint arXiv:2510.03215},
  year={2025}
}