概览
有选择地迭代,而非一味加深
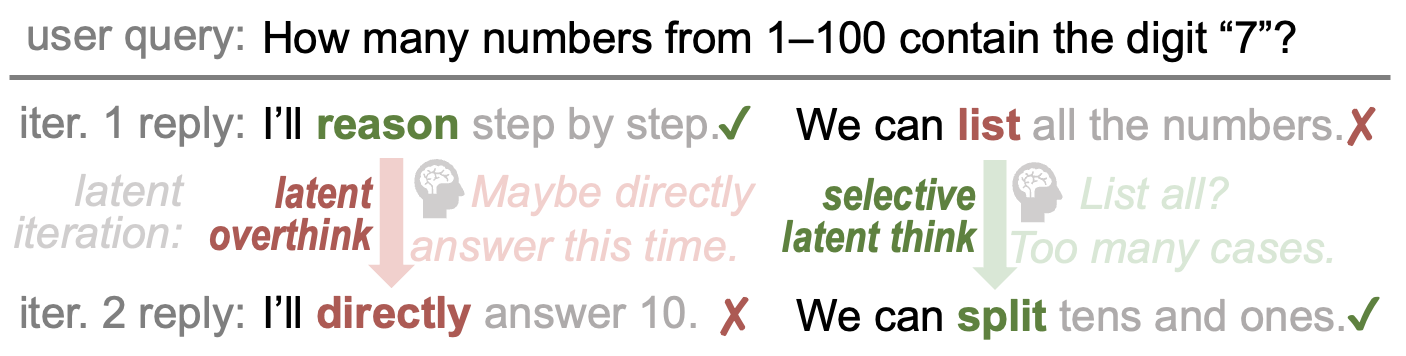
循环 Transformer 通过多次隐空间迭代改进 token 预测。但对所有 token 反复计算,既浪费算力,也可能将原本正确的预测改错,产生隐空间过度思考。
关键发现
大多数 token无需再次迭代
我们发现,额外迭代有时会适得其反,导致隐空间过度思考。有选择地分配迭代,可以更充分地发挥循环模型的潜力。
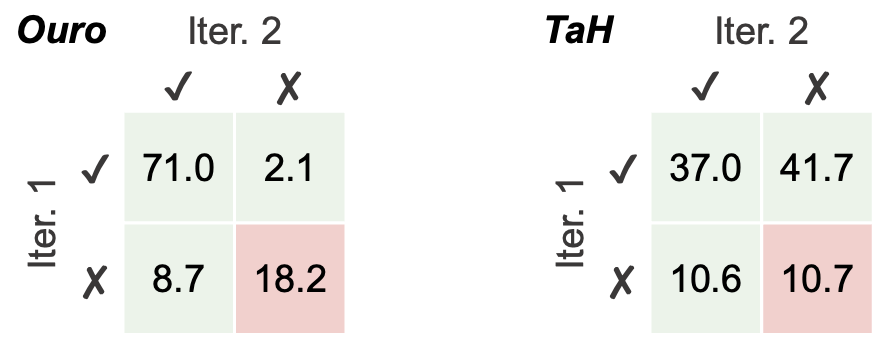
Ouro 要求每一轮迭代都预测全部 token,不同深度能正确预测的 token 大量重叠,仍有不少 token 始终预测不对。TaH 让更深层迭代专注于困难 token,减少重复覆盖,提高选择性迭代的效果。
架构
TaH 的设计
三个协同组件,让选择性隐空间迭代高效运行。
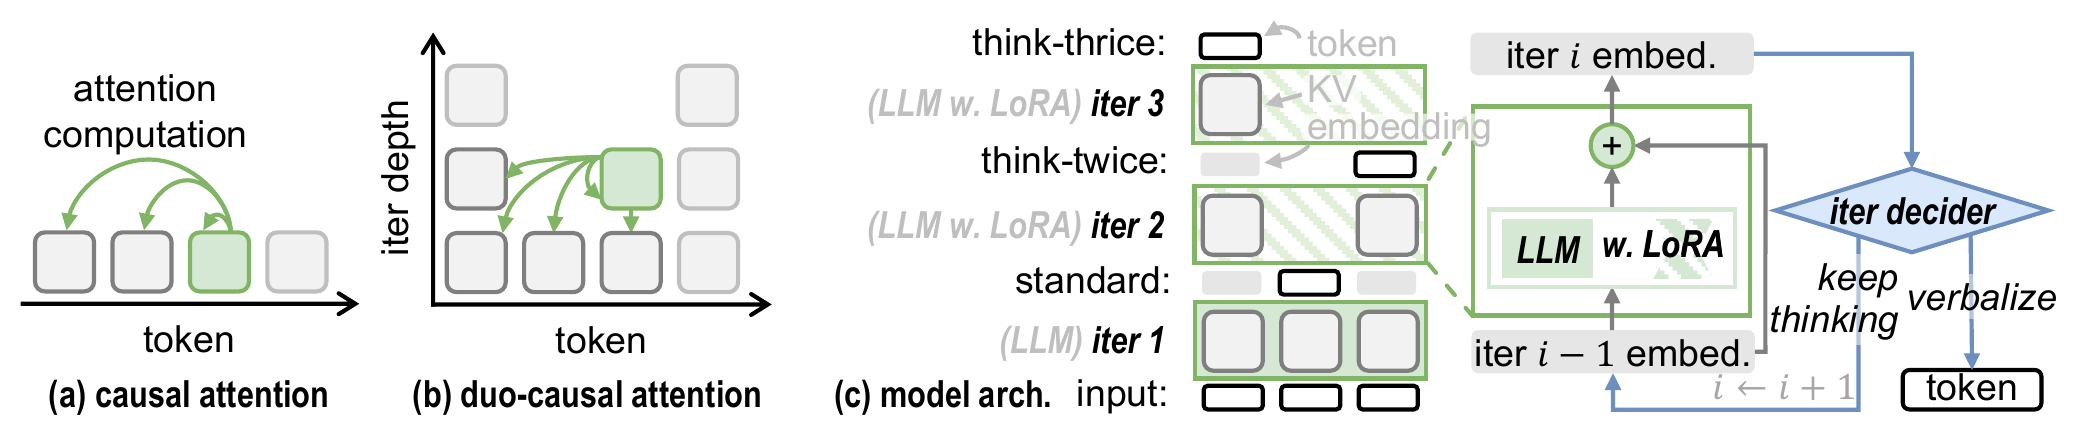
TaH 架构概览。(a)标准因果注意力。(b)双维因果注意力,将因果关系扩展至两个维度。(c)借助 LoRA 适配器和神经迭代决策器,TaH 为每个 token 选择继续迭代或输出。
双维因果注意力
同时考虑 token 位置和迭代深度的因果关系,兼容 FlashAttention,无需定制 CUDA 核函数。
深度感知 LoRA
在 $d > 1$ 时启用 LoRA,将目标从通用的下一 token 预测转为困难 token 的精炼,新增参数少于 3%。
神经迭代决策器
轻量 MLP 判断哪些 token 需要更深的计算,通过稳定的两阶段训练学习 oracle 策略。
第一次前向传播
token 嵌入在深度 $d=1$ 进入 LLM 主干,使用原有预训练权重 $\theta$,不启用 LoRA。模型先完成标准的下一 token 预测,再由决策器判断是否需要继续精炼。
双维因果注意力
标准因果注意力只允许访问此前的位置。双维因果注意力将因果关系扩展到两个维度:此前的 token 位置,以及更浅的迭代深度。形式化表示为 $X_{\le i}^{(\le d)} = \{x_j^{(k)} \mid j \le i, k \le d\}$。
深度适配器(LoRA)
当迭代深度 $d > 1$ 时,在共享主干上启用 LoRA:$\theta_d = \theta + \Delta$。目标由通用的下一 token 预测转为困难 token 的精炼,迭代间的残差连接则让精炼过程更易学习。
神经迭代决策器
轻量 MLP($\mathcal{I}_\phi$)拼接 LLM 浅层、中层和最后一层的隐藏状态,预测继续迭代的概率 $\hat{c}_i^{(d)} \in [0,1]$。若 $\hat{c}_i^{(d)} < c_{\text{threshold}}$,则输出 token;否则进入下一次迭代。
两阶段训练
LLM 主干与迭代决策器紧密耦合,直接联合训练容易不稳定。我们用固定的 oracle 策略 $\pi$ 将训练分为两个阶段:
阶段一:训练主干
在 $\pi$ 指导的迭代路径上微调 LLM($\theta$)和 LoRA($\Delta$),以 oracle 指定深度的下一 token 预测作为训练目标。这样既保留简单 token 的首轮预测能力,也让深层迭代学习精炼困难 token。
阶段二:训练决策器
冻结主干,用加权二元交叉熵训练决策器($\phi$),使其模仿 $\pi$ 的继续迭代决策。类别权重用于处理“继续”与“停止”的标签不均衡。
实验
推理基准结果
我们在三个模型规模、九项推理基准上评估 TaH。TaH 移除一层主干,以保持与基线相同的参数量;TaH+ 保留完整主干,新增参数不到 3%。下方准确率增益以 TaH+ 相较 Standard 计算。
| 方法 | AIME25 | Olympiad | AMC23 | MATH500 | GSM8K | GPQA | MMLU | HE++ | MBPP++ | 平均值 |
|---|---|---|---|---|---|---|---|---|---|---|
| Standard | 1.9 | 15.4 | 22.7 | 39.9 | 58.2 | 31.1 | 54.2 | 16.8 | 28.8 | 29.9 |
| SoftThink | 2.9 | 14.0 | 22.2 | 39.6 | 55.9 | 24.7 | 53.0 | 14.3 | 29.5 | 28.5 |
| Ouro | 2.1 | 14.2 | 19.7 | 37.4 | 56.6 | 35.4 | 54.0 | 18.9 | 23.5 | 29.1 |
| AlwaysThink | 1.3 | 12.6 | 21.9 | 37.8 | 52.6 | 30.8 | 51.4 | 9.1 | 13.8 | 25.7 |
| TaH | 2.1 | 19.1 | 24.1 | 46.2 | 63.6 | 29.0 | 56.4 | 21.6 | 33.9 | 32.9 |
| TaH+ | 4.6 | 20.6 | 24.7 | 51.8 | 67.6 | 31.3 | 59.0 | 22.0 | 35.1 | 35.2 |
A800 上的实际运行效率
1.7B 模型在单张 NVIDIA A800 上运行 AIME25,最大输出长度为 8K:
| Standard | AlwaysThink | TaH | |
|---|---|---|---|
| 平均深度 | 1.00 | 2.00 | 1.06 |
| 显存(GB) | 4.3 | 6.8 | 4.6 |
| 延迟(s) | 210.6 | 747.2 | 301.4 |
| 吞吐量(token/s) | 38.9 | 11.0 | 27.2 |
在此设置下,TaH 仅让 6% 的 token 迭代两次。相较 AlwaysThink,显存占用减少 32%,解码延迟降至约 1/2.48。Standard 的延迟仍然更低。
研究总结
主要贡献
选择性隐空间迭代
我们揭示循环 Transformer 中的隐空间过度思考现象,并通过选择性迭代将计算集中在困难 token 上。
为选择性迭代设计的架构
双维因果注意力、深度感知 LoRA 和神经迭代决策器共同支持选择性迭代,并保留完整的训练并行性。
兼顾效果与效率
在 0.6B 和 1.7B 规模上,TaH+ 相较 Standard 的九项基准平均准确率提升 5.3–6.2 个百分点,新增参数不到 3%。TaH 平均迭代 1.07 次,93% 的 token 跳过额外计算。
引用
引用我们的工作
如果 TaH 对您的研究有帮助,欢迎引用我们的论文。
@inproceedings{fu2026think,
  title={Think-at-Hard: Dynamic Looped Transformers for Improved Reasoning},
  author={Fu, Tianyu and You, Yichen and Chen, Zekai and Dai, Guohao and Yang, Huazhong and Wang, Yu},
  booktitle={Proceedings of the 43rd International Conference on Machine Learning (ICML 2026)},
  series={Proceedings of Machine Learning Research},
  volume={306},
  address={Seoul, South Korea},
  note={Best Paper Shortlist, ICLR 2025 LIT Workshop},
  year={2026}
}