TaH2
让循环大模型拥有更好的推理时扩展能力
关键发现
自适应深度,改善推理时扩展
增加推理时计算量、提高迭代深度上限后,TaH2 仍能持续提升准确率,而固定深度基线的增益逐渐趋缓。
研究动机
继续迭代后,预测如何变化?
迭代 1 → 2342 万个验证 token
“变化很小”指损失下降的绝对值 ≤ 10⁻³。这里的固定深度模型由 Qwen3-1.7B-Base 后训练得到。
不只判断“这个 token 难不难”,更要判断“再算一次有没有帮助”。
方法
学会何时继续迭代
用额外迭代带来的实际收益,让模型主干与决策器共同学习。
架构左:token 级深度 · 右:一次训练步骤
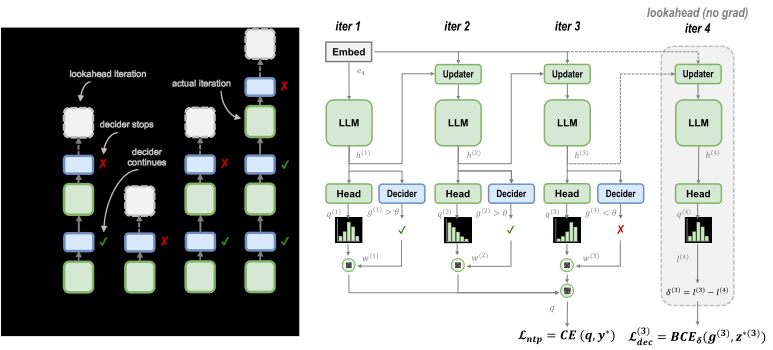
01 / 重新注入
每轮迭代保留输入信息
可学习的更新器融合原始嵌入与上一轮隐藏状态。
02 / 深度监督
从迭代收益中学习
在线生成兼顾计算成本的深度标签,让决策器学会把额外计算用在有收益的地方。
03 / 融合预测
利用各轮迭代的预测
依据停止概率,对已执行迭代的预测进行加权。
从 TaH 到 TaH2,改变了什么?
TaH 分阶段训练,采用离线生成的 top-1 预测不匹配标签。TaH2 引入前瞻深度监督,让标签随当前主干的迭代收益更新,并联合训练主干、更新器和决策器。训练与推理都遵循决策器的阈值决策;扩展的双维因果注意力保证 token 位置与迭代深度上的因果关系。
推理时,继续迭代概率低于 0.5,或达到深度上限,token 就会停止。仅用于训练的前瞻计算在推理时省去。在所研究的模型规模上,更新器和决策器新增的参数不到 3%。
实验结果
计算量、准确率与延迟
从推理时扩展、训练损失和实际服务效率三方面评估 TaH2。
推理时扩展与训练损失
推理时扩展输出上限 · 4K–16K
准确率(%)
训练训练步数 0
SFT 验证损失
实际推理服务Mini-SGLang · A800 · AIME26
运行效率
倍数均以 Standard 为基准。
准确率与实测端到端延迟
跨任务与规模
跨任务与模型规模的提升
从数学推理,拓展到代码、知识问答和工具调用。
九项基准平均提升 3.2 个百分点
TaH2 M=2 · 此处训练设置与 1.7B 实验不同。
九项基准完整结果 · 4B 与 8B
九项基准上的准确率,标注数值为 TaH2 相较 Standard 提升的百分点。
演示与示例
为每个 token自适应分配深度
通过生成过程录像与回答示例,观察不同 token 的迭代深度。
生成演示生成过程中的 token 级自适应深度
回答示例TaH2 M=8 · 三条采样得到的正确回答
研究团队
作者与团队
引用
引用我们的工作
如果 TaH2 对您的研究有帮助,欢迎引用我们的论文。
BibTeX
@article{you2026tah2,
  title={Improving Test-Time Scaling with Adaptive Looped Transformers},
  author={You, Yichen and Fu, Tianyu and Feng, Aosong and Lv, Xingtai and Ning, Xuefei and Ding, Ning and Wang, Yu},
  journal={arXiv preprint arXiv:2609.35748},
  year={2026}
}