概览
缩短注意力跨度,保留长上下文。
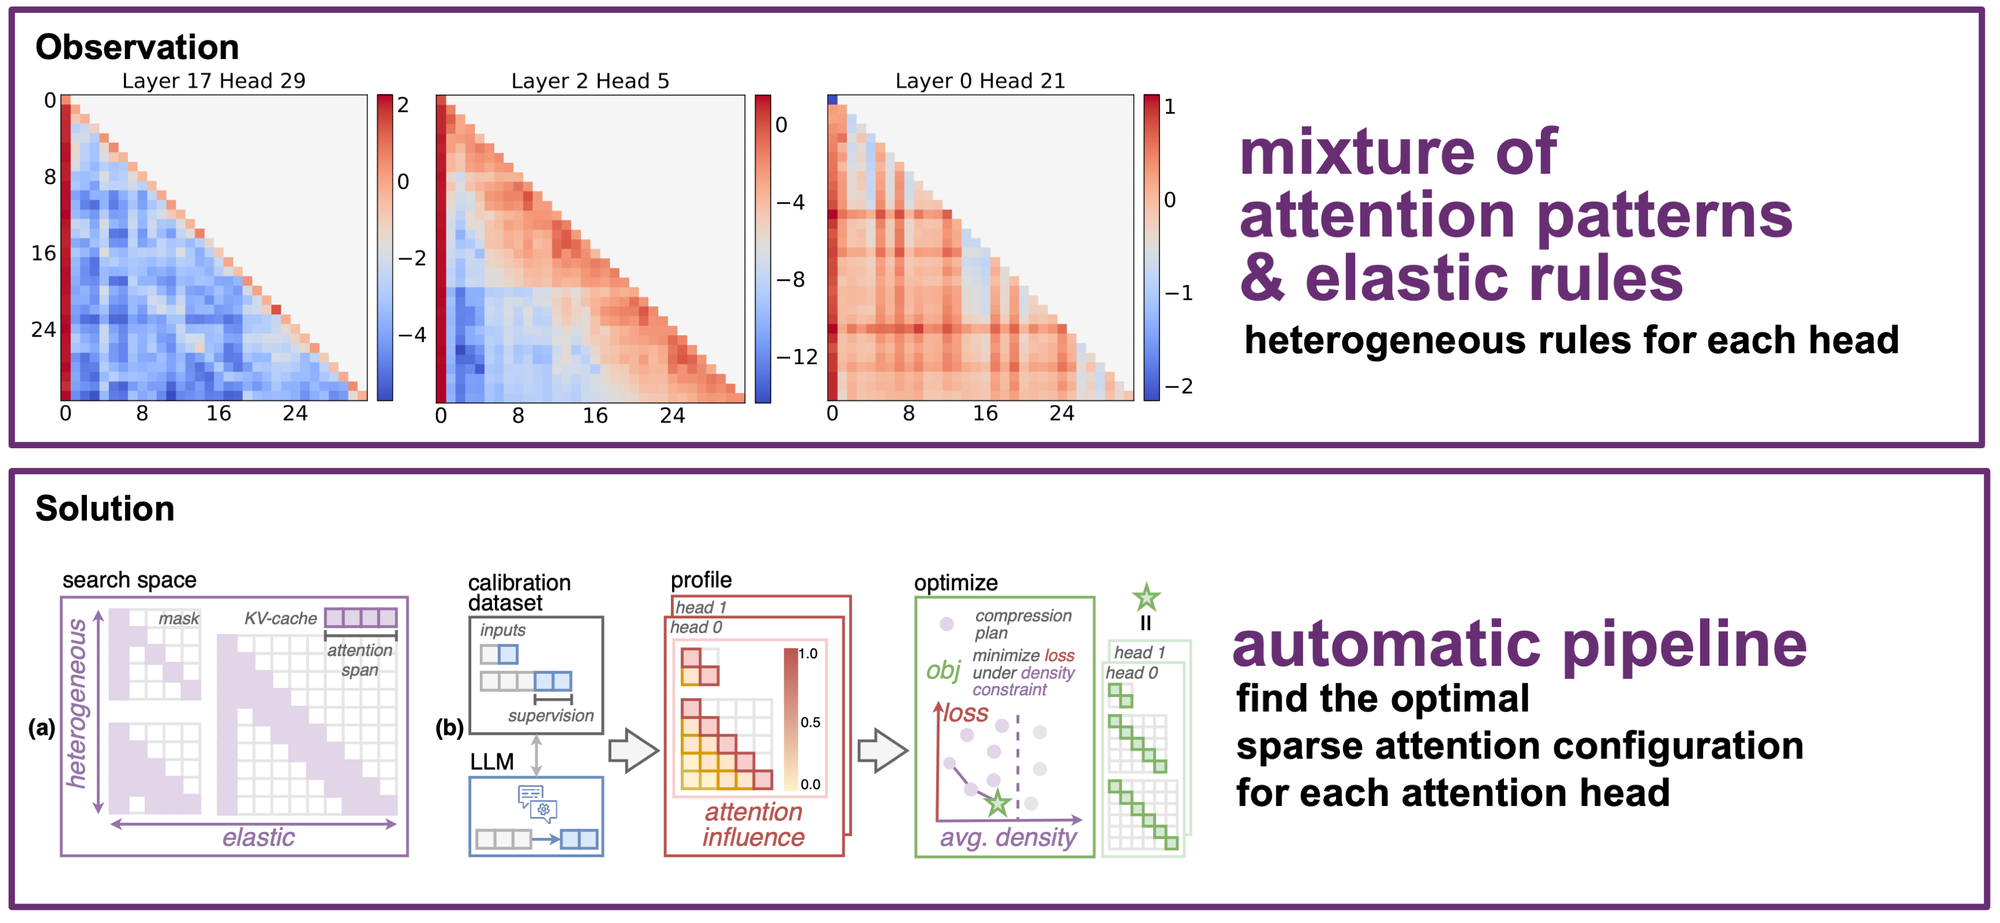
不同注意力头需要的上下文范围并不相同。MoA 为每个头设计随输入长度变化的窗口:关注局部的头节省计算,关注全局的头保留足够的上下文。
统一窗口难以合理分配预算。有些头只需局部信息,有些头则依赖更广的上下文来完成检索与理解。
MoA 为每个头搜索弹性窗口规则。在给定注意力密度下,各个头的窗口长度分别随输入长度调整。
无需重新训练模型。先通过校准数据评估注意力的影响,再优化各个头的窗口配置。
关键发现
注意力头的差异,体现在两个方面。
对预训练模型的分析揭示了两种差异,也解释了为什么统一的滑动窗口难以兼顾整个模型。
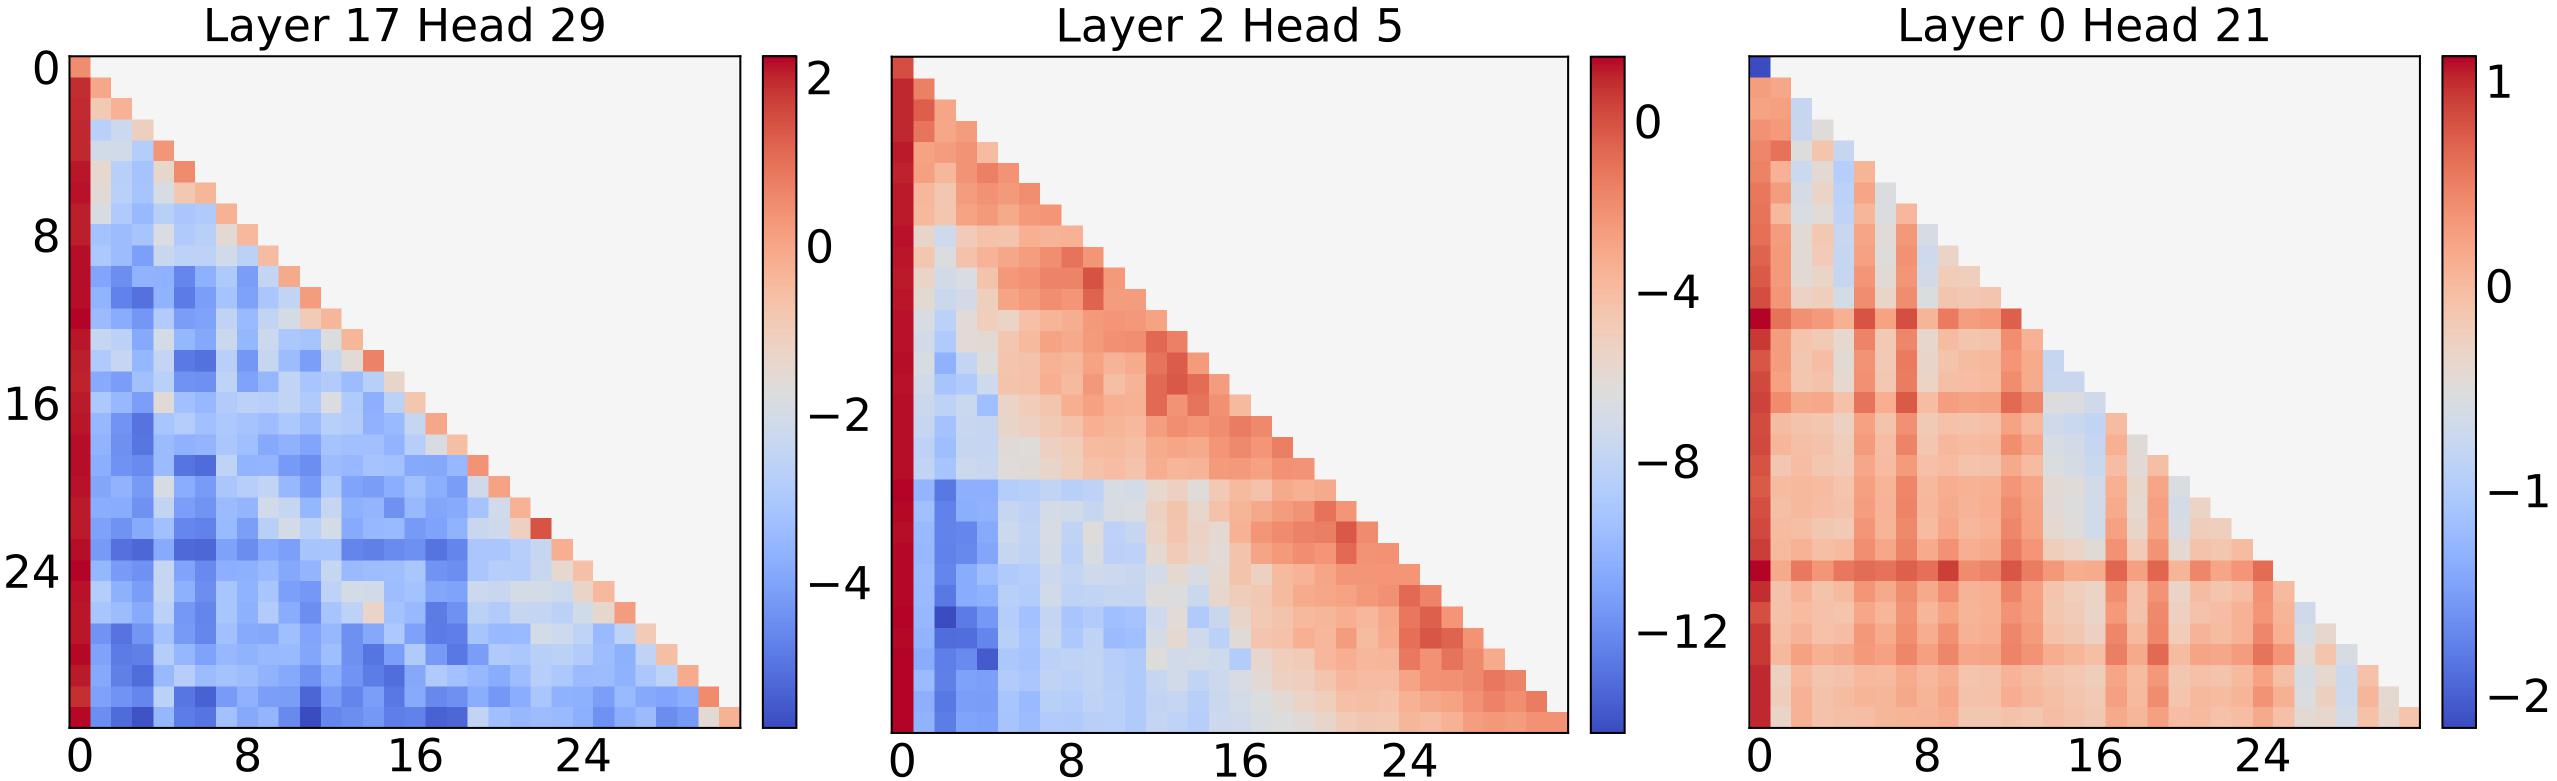
关注范围因头而异。
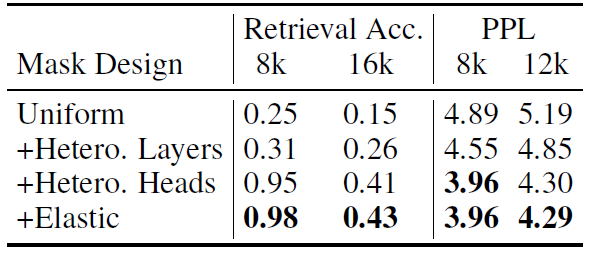
在相同输入长度下,有些头的注意力集中在对角线附近,有些则覆盖整个输入。统一窗口会截断全局信息,却仍在局部头上浪费计算与 KV cache。在 25% 注意力密度、8k 输入长度的实验中,异构弹性规则将检索准确率从 25% 提升至 98%。
窗口随输入长度变化。
短输入下,许多头看起来都在关注全部内容;输入变长后,差异才逐渐显现。有些头始终保持固定的局部窗口,有些则随输入长度扩大。MoA 用线性规则 S = α + β · N 描述这种变化,并为每个头搜索 α 和 β。
局部,固定窗口
S = 1.6k (β = 0)
占输入长度的 40%
中等,固定窗口
S = 5.6k (β = 0)
占输入长度的 100%
全局,弹性窗口
S = 0.9 · N (β > 0)
占输入长度的 90%
N×N 因果注意力矩阵示意。蓝色区域按窗口规则保留,浅色区域被屏蔽。在 4k 输入下,B 和 C 看起来相似;到 16k 时,B 的窗口保持不变,C 的窗口则继续扩大。
方法设计
为不同的头,搜索合适的窗口。
MoA 构建弹性窗口的搜索空间,用长上下文校准数据评估注意力的影响,再为各个头选择窗口规则。
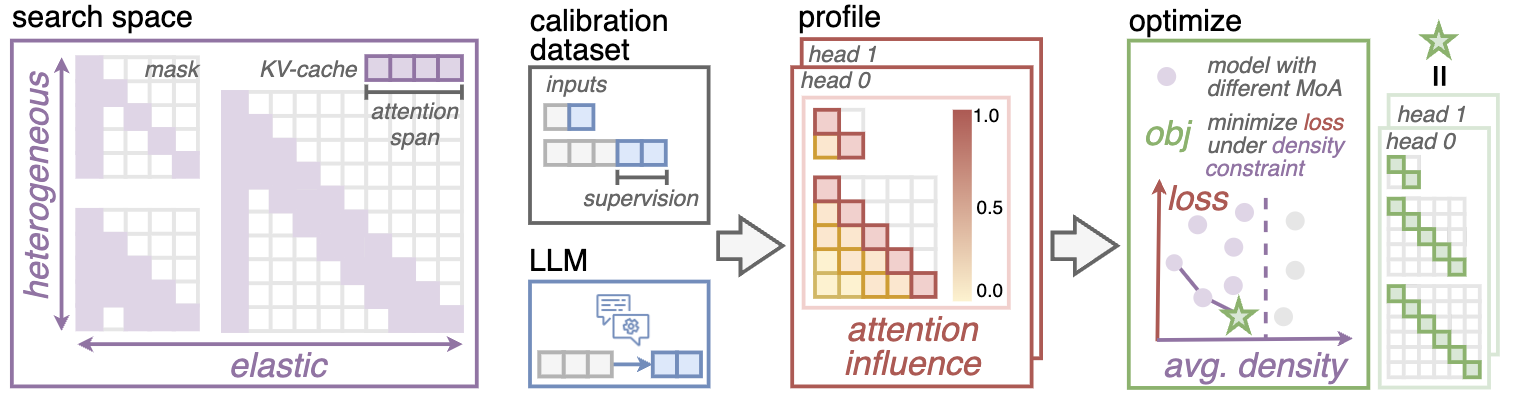
弹性搜索空间
候选规则将输入长度映射为窗口跨度,并满足硬件对计算块大小的要求。
影响度评估
通过一阶梯度估计:屏蔽不同注意力位置,会怎样改变预测损失。
自动优化
在密度约束下搜索各个头的窗口配置,再用未参与搜索的序列长度验证效果。
校准数据
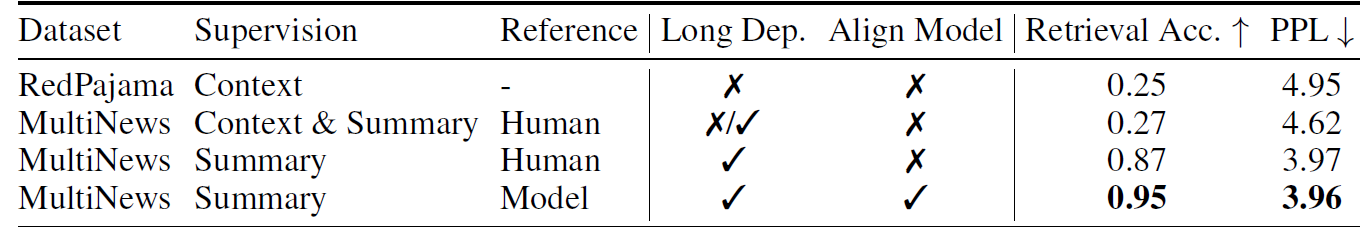
校准任务,需要真正依赖长上下文。
MoA 采用多文档摘要任务,以原始稠密模型生成的摘要作为参考,评估压缩对长距离信息利用的影响。
跨文档的信息
摘要需要综合多篇文档中的内容。
依赖上下文的输出
在生成摘要的部分计算损失。
与模型一致的参考
以稠密模型生成的摘要作为监督。
普通校准
RedPajama 上下文
MoA 校准
MultiNews + 稠密模型参考
实验结果
兼顾准确率与效率。
从长上下文检索、LV-Eval、LongBench 到困惑度、吞吐量与显存占用,全面评估效果,并验证各项设计的作用。
长上下文任务表现
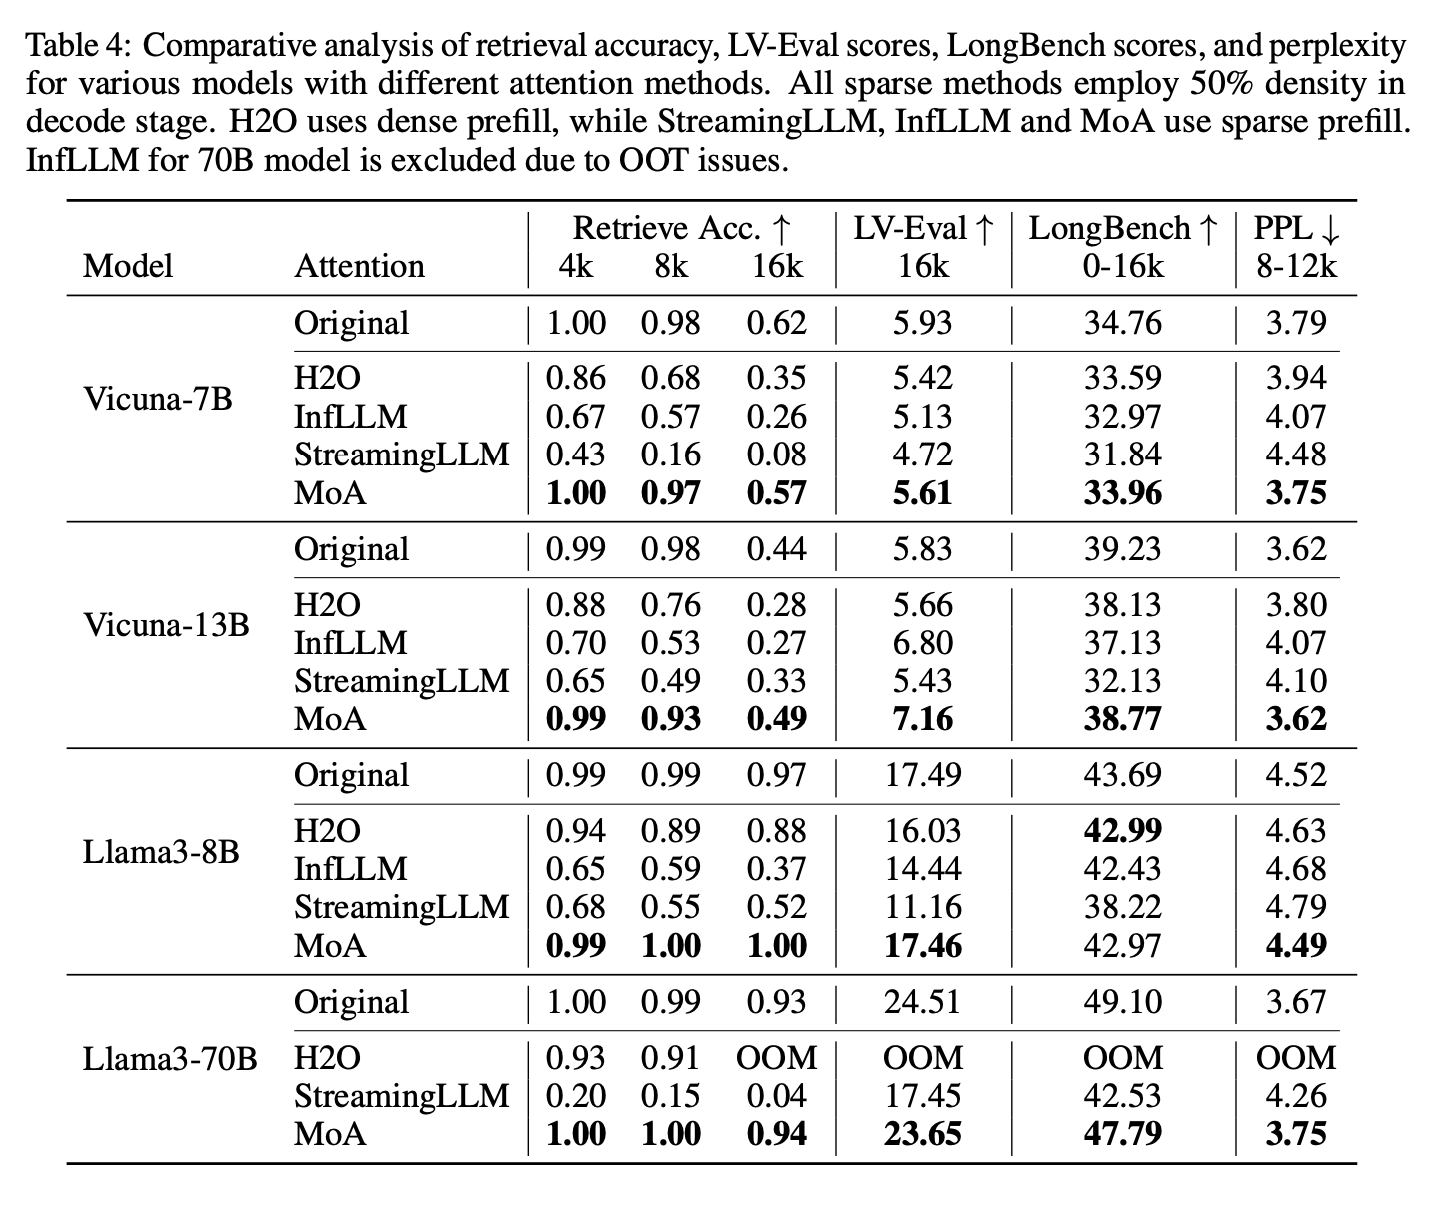
在 50% 注意力密度下,MoA 在检索、LV-Eval、LongBench 和困惑度方面均接近完整注意力。LV-Eval 和 LongBench 的最大相对降幅分别为 5% 和 3%,检索准确率的平均降幅低于 1%。
在 Vicuna-7B 上,MoA 的有效上下文长度最高可达各个头平均注意力跨度的 3.9 倍(图 7)。这里的有效上下文长度,指检索准确率保持在 90% 以上时的最长输入。
推理速度与显存效率
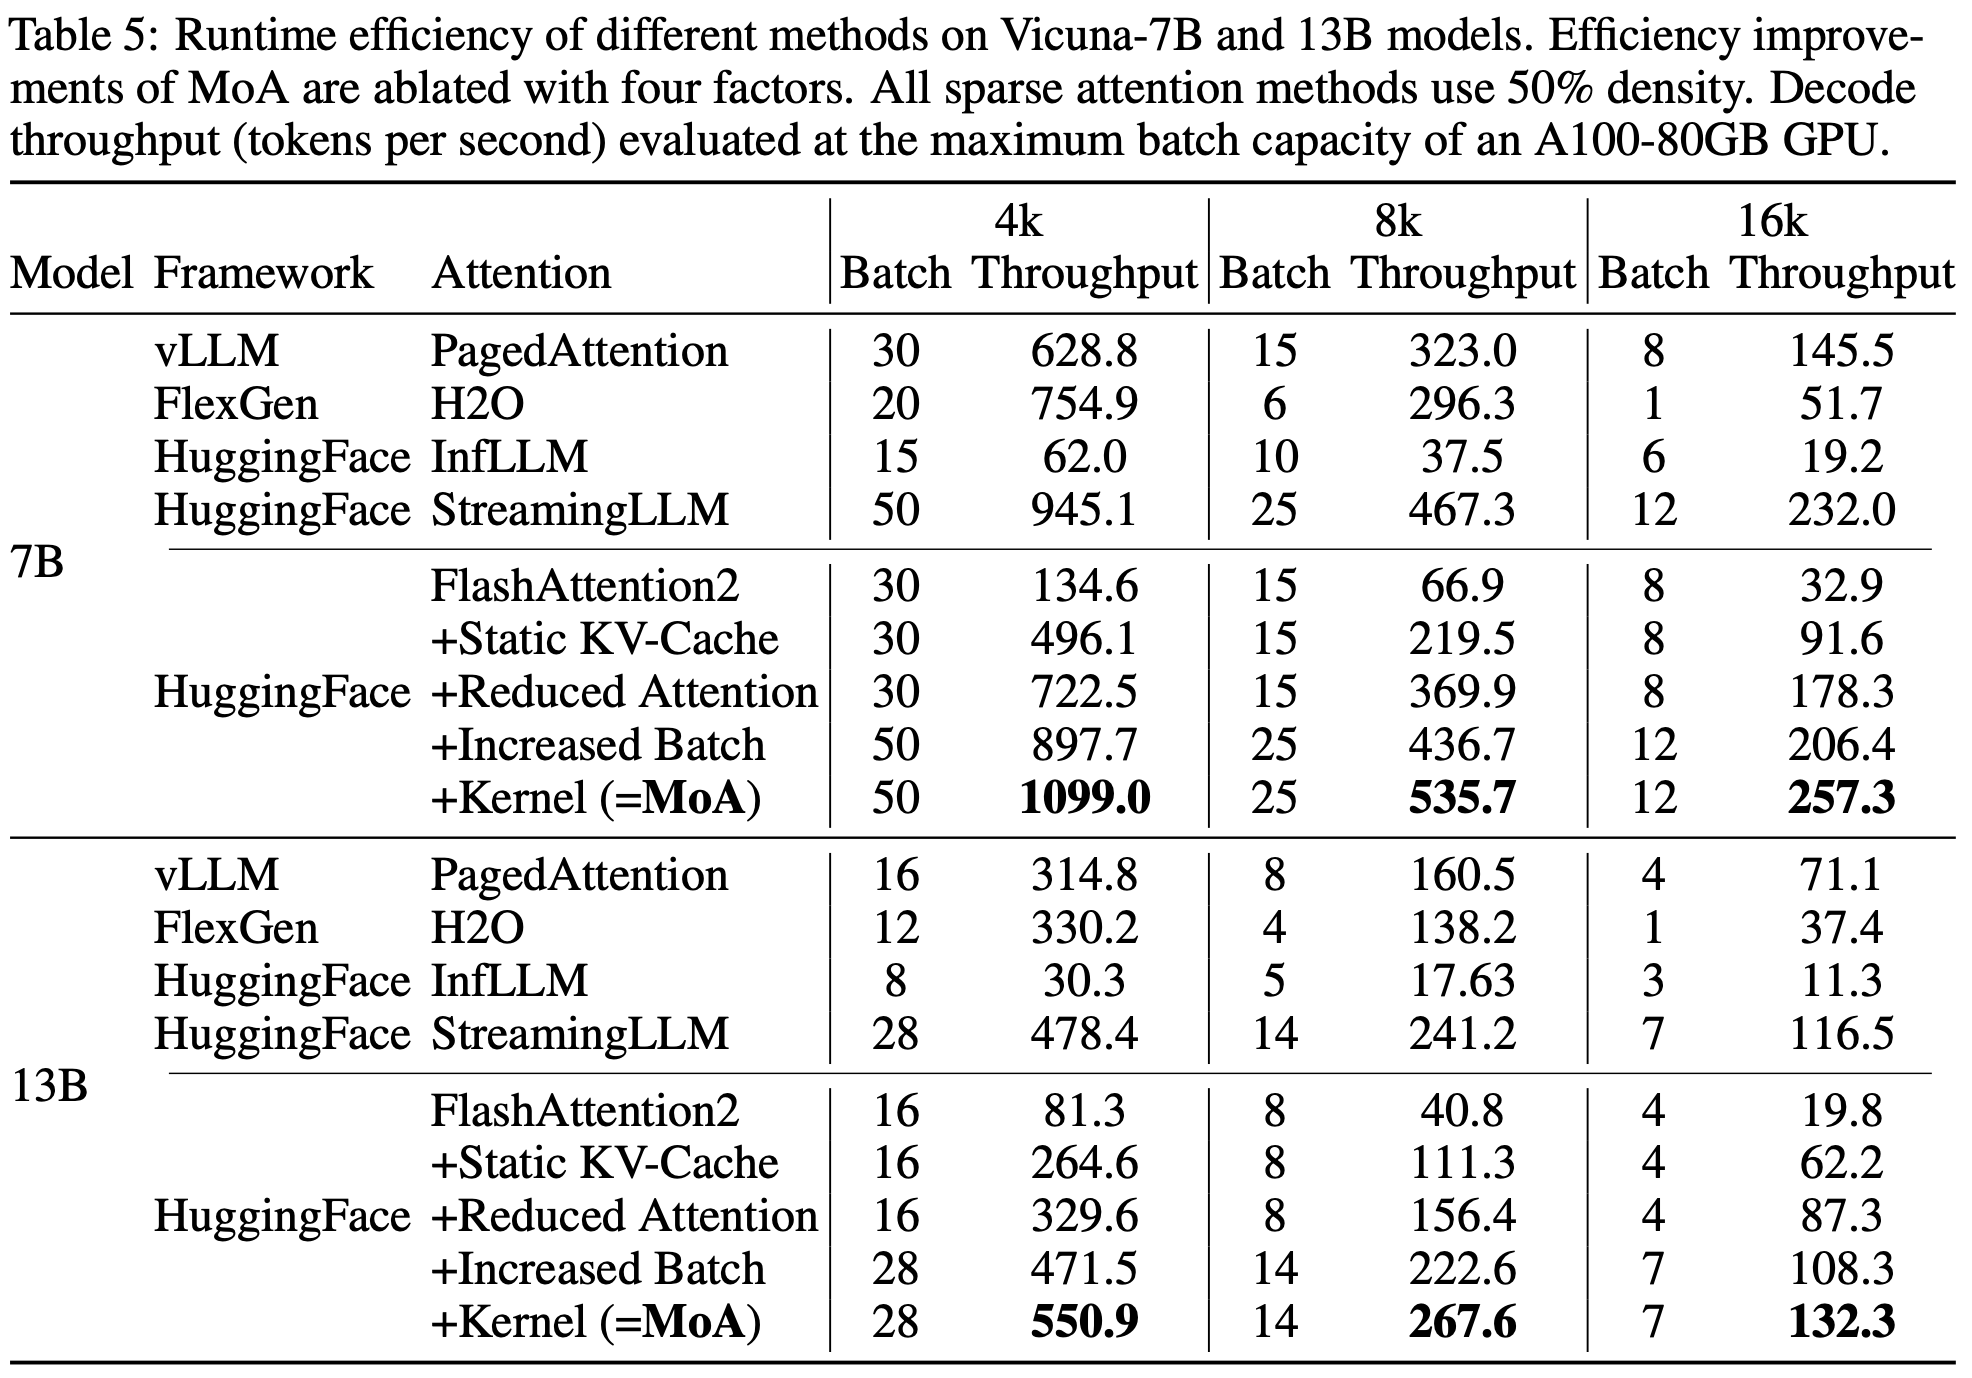
MoA 减少注意力计算,并限制 KV cache 大小,从而容纳更大的批量;专用 CUDA 内核支持异构窗口。吞吐量实验使用各方法能够支持的最大批量,因此收益同时来自单次计算加速和批量扩大。
搜索空间消融
从统一窗口出发,逐步引入层间差异、头间差异和弹性规则。在 25% 注意力密度下,头间差异和弹性规则带来的检索提升最为明显。
演示
从校准到部署
完成一次校准,为模型搜索注意力配置,再按照选定的 KV cache 预算进行长上下文推理。
用与模型输出一致的长上下文数据进行校准。
在密度预算内,为各层、各头搜索弹性窗口规则。
用固定大小、稀疏且因头而异的 KV cache 配置部署推理。
引用
引用我们的工作。
如在研究中使用 MoA,欢迎引用我们的论文。
@inproceedings{fu2025moa,
  title={Mixture of Attention Spans: Optimizing LLM Inference Efficiency with Heterogeneous Sliding-Window Lengths},
  author={Fu, Tianyu and Huang, Haofeng and Ning, Xuefei and Zhang, Genghan and Chen, Boju and Wu, Tianqi and Wang, Hongyi and Huang, Zixiao and Li, Shiyao and Yan, Shengen and Dai, Guohao and Yang, Huazhong and Wang, Yu},
  booktitle={Conference on Language Modeling},
  year={2025},
  url={https://arxiv.org/abs/2406.14909}
}