研究背景
大模型推理强,计算成本高。
小模型生成快,却容易出错。R2R 希望用小模型承担大部分计算,在关键位置借助大模型的推理能力。
小模型(1.5B)
生成速度快
准确率有限
R2R 路由
结合大小模型优势
按 token 选择模型
大模型(32B)
推理准确
速度慢、成本高
核心发现
只有少数 token 会改变推理路径。
在 760 万 token 的路由训练数据中,给定相同上下文,R1-1.5B 与 R1-32B 的预测大多一致。约 5% 的 token 被标为会引发推理分歧。
交互演示
R2R 如何完成一次推理
通过预设示例展示 token 路由。续写对比说明了离线标注的依据,并非实时模型输出。
两种续写的对比说明了差异是否影响推理。
视频演示
左侧为 R1-32B,右侧为 R2R。红色 token 表示调用了大模型。
方法
用轻量路由器识别关键 token
R2R 自动标注哪些 token 会影响推理,再训练轻量神经路由器,判断何时需要调用大模型。
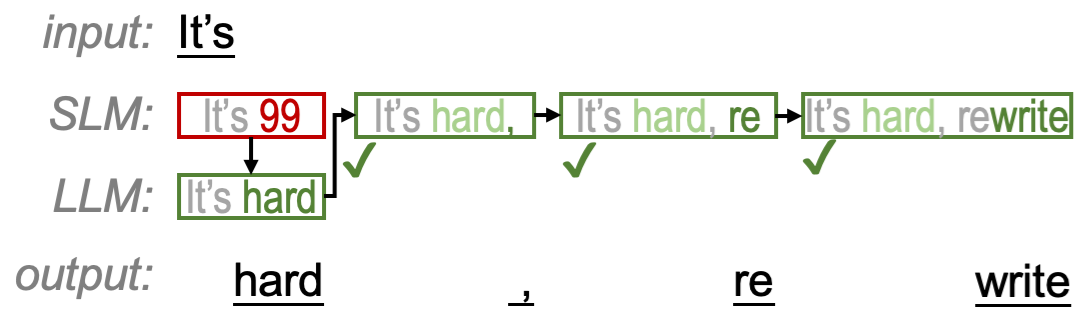
自动生成路由训练数据
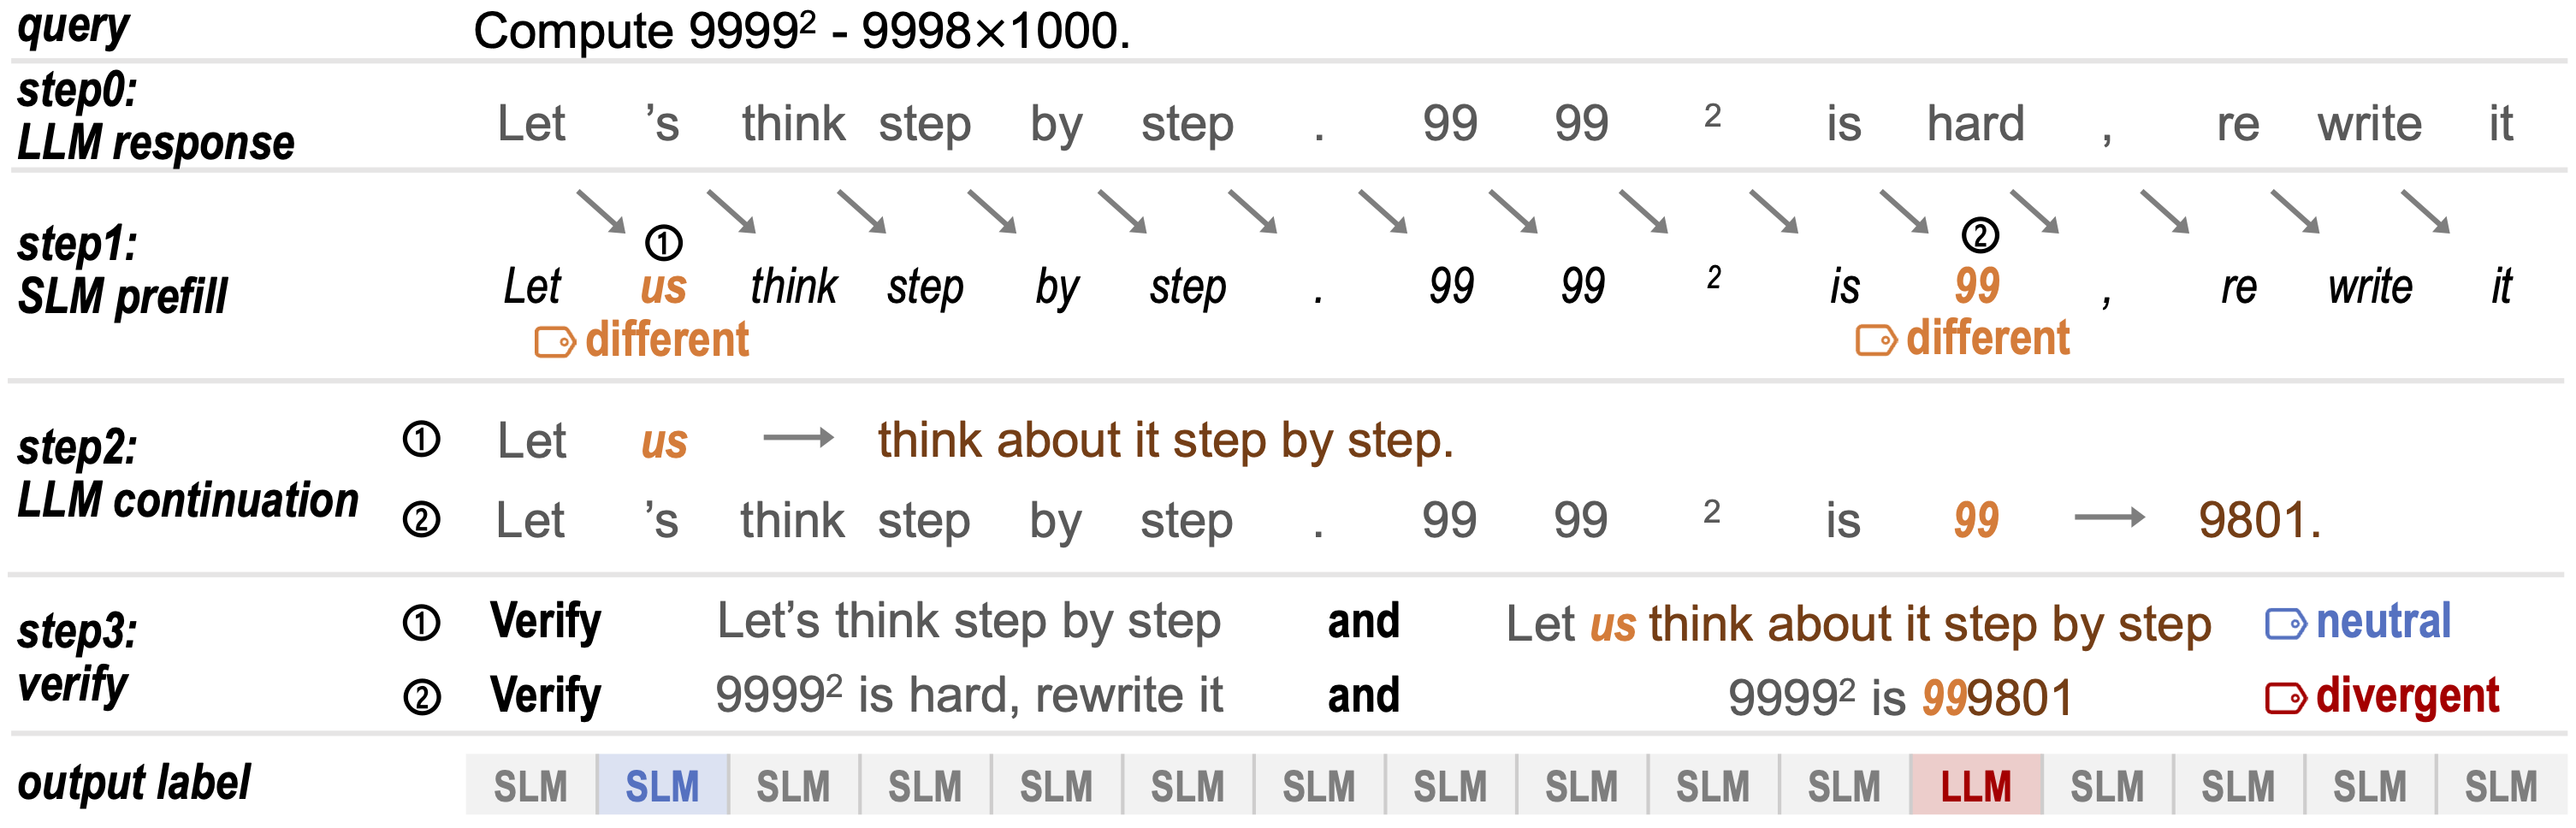
我们设计了自动生成 token 级路由标签的流程,无需昂贵的人工标注:
- 大模型生成参考回答。
- 小模型预填充该回答,找出两个模型预测不同的 token。
- 在这些位置换用小模型的 token,再让大模型续写到句末。原回答则作为大模型自身的参考续写。
- 验证模型比较两种续写,判断差异是否改变句子的含义或推理。
这套流程可自动生成大规模训练数据,让路由器学习哪些 token 差异真正影响推理。
学习何时调用大模型
生成训练标签时,先比较两个模型对下一个 token 的预测。预测一致,就采用小模型输出;预测不同,再通过续写和验证区分两种情况:
- 不影响推理:差异不改变推理结果,采用小模型输出。
- 引发分歧:改变推理路径,交给大模型处理。
续写和验证只用于离线标注。实际推理时,路由器根据小模型的特征预测分歧,分数超过阈值才调用大模型,从而近似实现上述策略。
神经路由器结构
路由器是一个只有 56M 参数的前馈网络,接收小模型的三类特征:
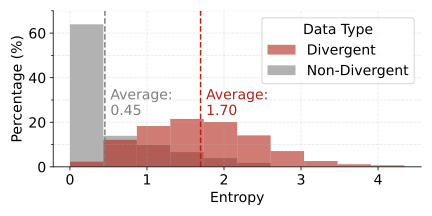
- 小模型前 100 个 logits:反映预测的不确定性,较高的熵意味着更可能出现分歧。
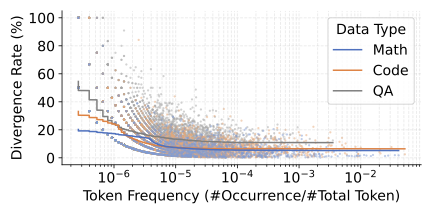
- token 嵌入:反映词频偏差,低频 token 更容易引发分歧。
- 最后一层隐藏状态:提供当前生成步骤的语义上下文。
路由器输出分歧分数,支持即时路由决策。无需重新训练,调整阈值就能改变调用比例。论文主实验中,大模型处理约 11–15% 的 token。
哪些特征能预示推理分歧
小模型预测的熵
引发分歧的 token,其小模型输出熵平均约为其他 token 的 3.8 倍,说明小模型在这些位置更不确定。
token 频率
训练数据中,低频 token 更容易引发分歧,因此 token 的稀有程度可作为路由预测信号。
实验结果
更低的推理成本,更高的准确率。
R1-1.5B 与 R1-32B 协作,平均激活 5.6B 参数,准确率达到 46%;R1-14B 和 R1-32B 的平均准确率分别为 43% 和 50%。
*成本按“输出 token 数 × 平均激活参数量(十亿)”估算,计入小模型、路由器,以及按调用比例加权的大模型参数。该指标用于比较解码开销,不代表实测延迟。
在 AIME 上使用两张 A800-80GB,生成速度从 30.5 提升至 84.3 token/s(2.76×),平均请求延迟从 498 降至 218 秒(2.28×)。见表 3。
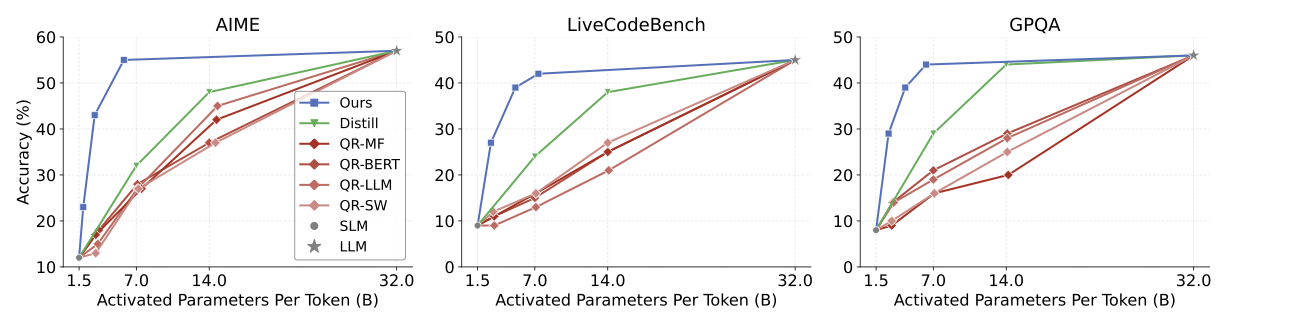
在 AIME、GPQA 和 LiveCodeBench 三项基准上,R2R 均改善了准确率与计算成本的帕累托前沿。
各项基准的详细结果
表 2 设置:AIME 2024–2025、LiveCodeBench(2024 年 8 月至 2025 年 1 月)和 GPQA-Diamond;贪心解码,输出上限为 32K token。末列为跨基准平均激活参数量。
| 方法 | AIME | LiveCodeBench | GPQA | 平均参数量 |
|---|---|---|---|---|
| R1-1.5B (SLM) | 12% | 9% | 8% | 1.5B |
| R1-7B | 32% | 24% | 29% | 7.0B |
| R1-14B | 48% | 38% | 44% | 14.0B |
| R2R(我们的方法) | 55% | 39% | 44% | 5.6B |
| R1-32B (LLM) | 57% | 45% | 46% | 32.0B |
路由行为分析
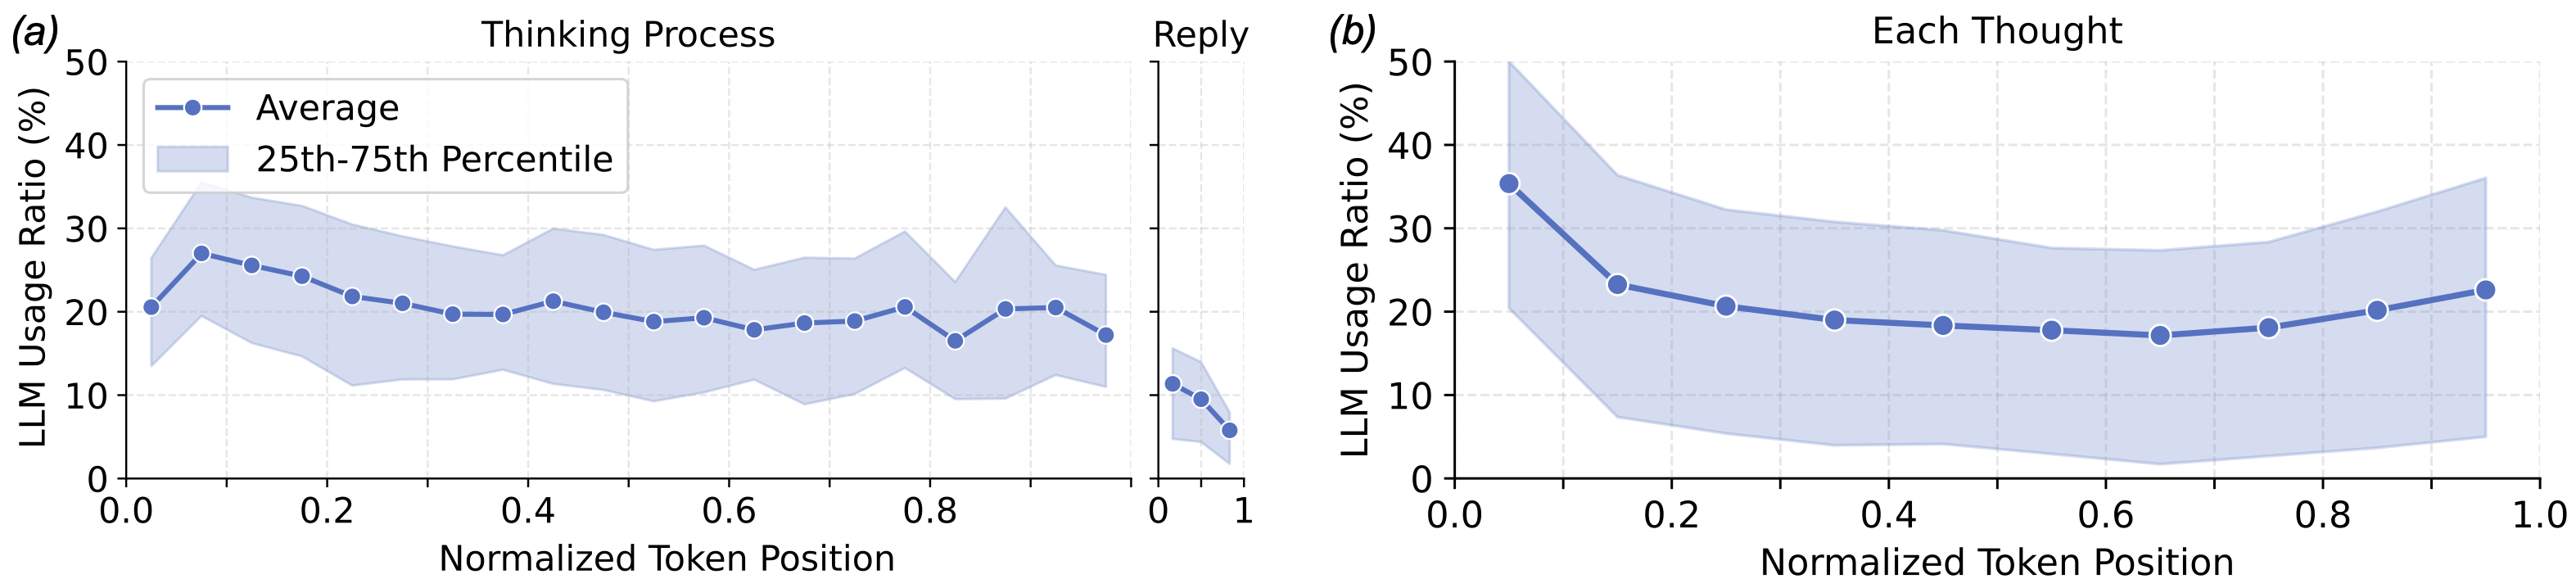
R2R 在直接作答时较少调用大模型,在每段思考的开头和结尾则更频繁。这些位置往往决定后续推理的方向。
引用
引用本研究
如果 R2R 对研究有所帮助,欢迎引用我们的论文。
@article{fu2025r2r,
          title={R2R: Efficiently Navigating Divergent Reasoning Paths with Small-Large Model Token Routing},
          author={Fu, Tianyu and Ge, Yi and You, Yichen and Liu, Enshu and Yuan, Zhihang and Dai, Guohao and Yan, Shengen and Yang, Huazhong and Wang, Yu},
          journal={arXiv preprint arXiv:2505.21600},
          year={2025}
        }